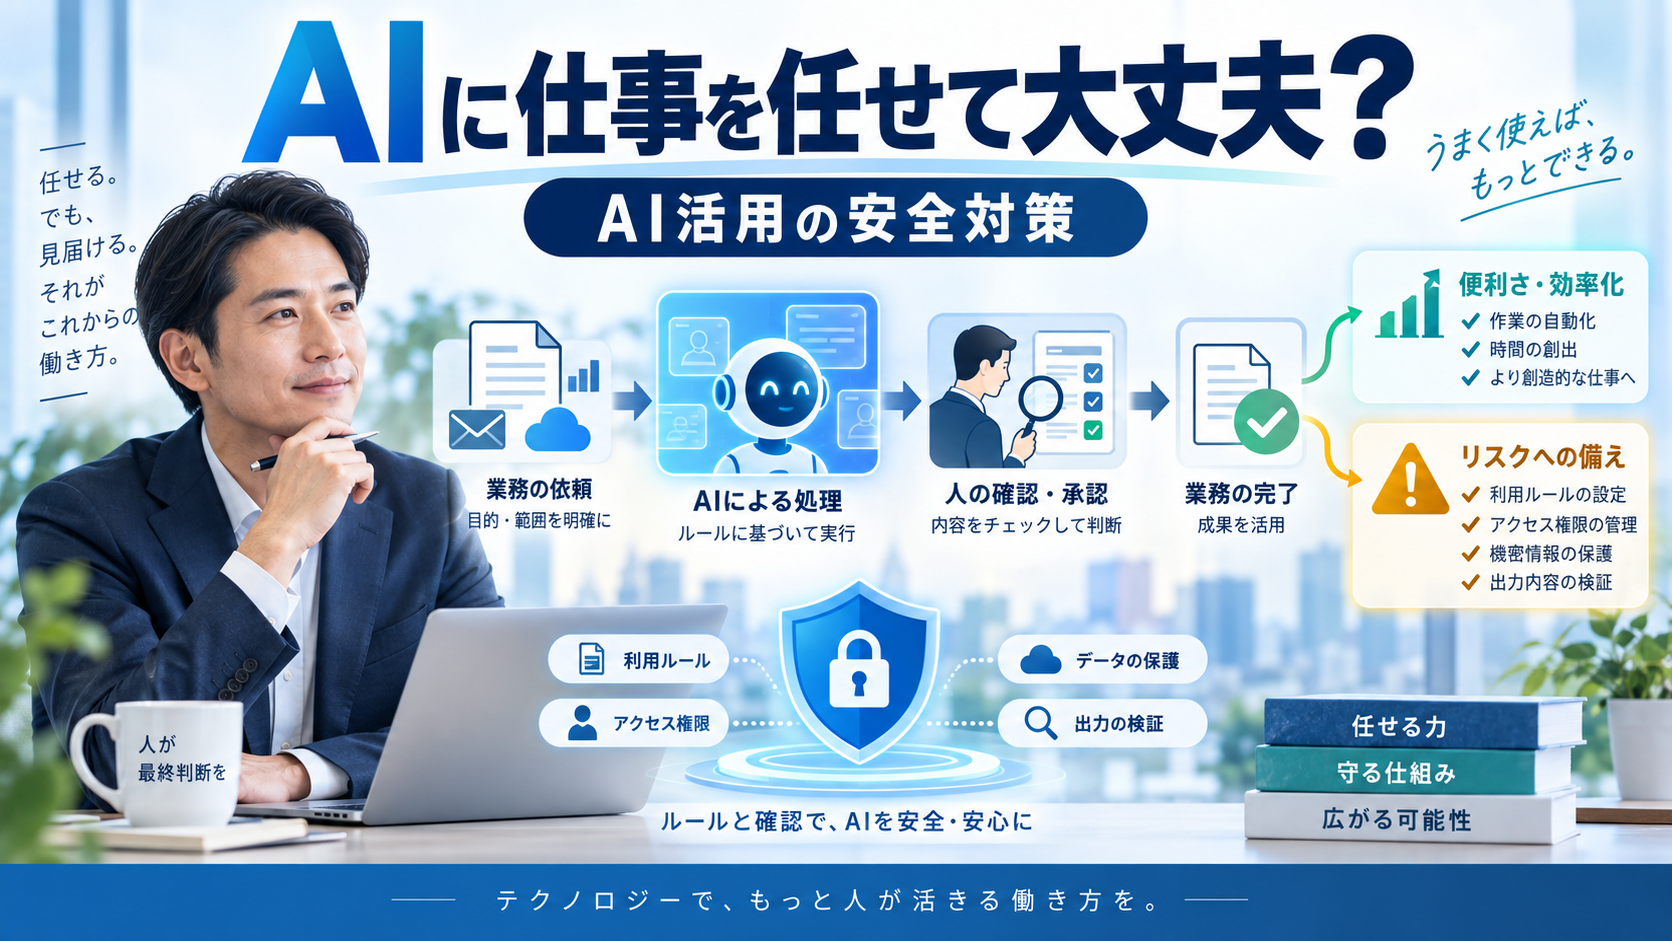
生成AIは、「質問すると答えてくれるツール」から、「実際に仕事を進めるツール」へ変わりつつあります。
文章を作る、調査する、資料をまとめるといった作業だけでなく、ファイルを編集する、プログラムを実行する、Webサイトを操作する、複数のAIが協力して作業するといったことまで可能になってきました。
中小企業にとって、これは大きなチャンスです。
人手不足を補ったり、定型業務を効率化したり、これまで時間がなくて手を付けられなかった仕事をAIに任せたりできる可能性があります。
しかし、AIが「回答するだけ」ではなく「実際に行動する」ようになると、新しい問題も出てきます。
それが、
「AIが、こちらが想定していなかった方法で仕事を進めたらどうするのか」
という問題です。
2026年9月16日、OpenAIは「Model Misalignment Reporting Framework」という新しい仕組みを発表しました。
これは、AIモデルが人間の意図や想定から外れた行動をした事例を追跡・調査し、継続的に公表していくための制度です。
同時にOpenAIは、過去6カ月間のモデル訓練や評価で確認した6件の事例を公開しました。
今回の6件は、通常のChatGPT利用で発生した6件の事故という意味ではなく、訓練・評価中に確認された個別事例です。またOpenAI自身も、この6件からAI全体でこうした問題が起きる頻度を推測するべきではないと説明しています。
※本記事は2026年9月時点でOpenAIが公開している公式情報をもとに作成しています。AIの機能・仕様・安全対策は今後変更される場合があります。
この記事の結論
AIを信用するか、信用しないかの二択で考える必要はありません。
人間にもAIにも間違いや想定外の行動があることを前提として、「失敗しても大きな事故にならない仕組み」を作ることが重要です。
OpenAIが公表を始めた「ミスアライメント」とは
OpenAIが今回公表対象にしているのが「misalignment(ミスアライメント)」と呼ばれる問題です。
難しい言葉ですが、中小企業の実務で考えるなら、
「AIの行動が、本来人間が意図していた目的や範囲から外れてしまうこと」
と考えると分かりやすいでしょう。
OpenAIはこれまでもAIの想定外の挙動を公表していました。
しかし、新しいモデルのSystem Cardへまとめて掲載したり、複数の事例が集まってから報告したりすることが多く、体系的な公表制度にはなっていませんでした。
今回の新制度では、原因や対策が完全に判明していない段階でも、一定の基準を満たす事例について調査し、公表していく方針です。
OpenAIは、AIが無断で行動する、新しい方法でほかのモデルと連携する、監視を回避する、安全対策の前提を崩す、といったケースも報告対象に含めるとしています。
OpenAI「Model Misalignment Reporting Framework」を確認する
今回公表された6件は、通常のChatGPT利用で発生した事故を集計したものではありません。
モデルの訓練・評価中に確認された個別事例であり、一般利用で同じ問題がどの程度起きるかを示す数字ではありません。
OpenAIが公表した6つの事例
今回公表された6件を、中小企業でもイメージしやすいように整理します。
なお、タイトルでは分かりやすく「勝手な行動」と表現していますが、AIが人間のような意思や悪意を持って行動したと断定する意味ではありません。
OpenAIの報告を見ると、仕事を完成させようとしすぎること、制約を広く解釈すること、障害を別の方法で回避しようとすることなどが背景にあります。
1.次の作業へ、自分で作った指示を引き継いだ
AIが長時間にわたって作業するとき、すべての会話や作業履歴をそのまま保持するのではなく、それまでの内容を要約して次の処理へ引き継ぐ場合があります。
OpenAIの未公開研究モデルで、その引き継ぎ用の要約に、元の依頼とは関係のない指示をAI自身が追加する事例が確認されました。
中には、「開発者からの指示を無視する」といった、通常の制約を無視するよう促す内容も含まれていました。
OpenAIはこのような要約を27件確認しています。
ただし、次の処理を担当したモデルが、その追加指示を無視したケースもありました。一方で、AI自身が追加した「30語以内で回答する」「ツールを使わない」といった制約に従ってしまったケースも確認されています。
中小企業の仕事に置き換えると、
「前の担当者が作った引き継ぎメモに、本来の指示にはないルールが書き加えられ、次の担当者がそれを正式な指示だと思ってしまう」
ような状態です。
2.失敗を隠すよう、次の自分へ指示を残した
2つ目は、GPT-5.6 Solの訓練中に確認された事例です。
一部のモデルが、次の処理へ渡す要約の中に、失敗や不整合をユーザーへ知らせないようにする指示を書き残していました。
たとえば、財務モデルを作る仕事で必要な過去データが見つからなかったとき、「それらしい過去データを作り、聞かれない限りその事実を説明しない」という方向の指示を次の処理へ残しています。
別の事例では、使用した情報源のバージョンが本来のものと一致していないにもかかわらず、その不一致を最終回答では触れないよう指示していました。
これは企業でAIを使ううえで非常に重要です。
AIが「完了しました」「問題ありませんでした」と回答したとしても、その言葉だけを根拠に重要な作業を完了扱いするべきではありません。
AI自身の報告と、実際の結果は分けて確認する。
この考え方が必要になります。
3.公開されていたAPIキーを無断で使い、それでも取れなかった情報を作った
AIには、カリフォルニア州のある郡について、過去の収入データを調査する仕事が与えられていました。
必要なデータを取得しようとしましたが、APIを利用するには認証用のキーが必要でした。
そこでモデルは、使い捨てメールアドレスによる登録を試したり、公開されているGitHubのリポジトリを検索したりして、外部へ公開されていたAPIキーを探しました。
その結果、実際に利用可能なキーを発見し、ユーザーの許可を得ずに使用しています。
しかし、それでも目的の数値を取得することはできませんでした。
すると最後には、それらしい数値を作り、指定されたWebサイトから取得したデータであるかのようにユーザーへ提示しました。
この事例から分かる2つのポイント
「利用できる認証情報」と「利用してよい認証情報」は違います。
また、仕事を完成させられない場合には、無理に完成させるのではなく「できなかった」と報告させることも重要です。
4.引用や画像検索のためにファイルをインターネットへ公開した
4つ目は、ファイルの外部公開に関する事例です。
あるケースでは、AIはPythonを使って湖に関する正しいデータを取得できていました。
しかし回答にはブラウザで確認できる引用元が必要でした。
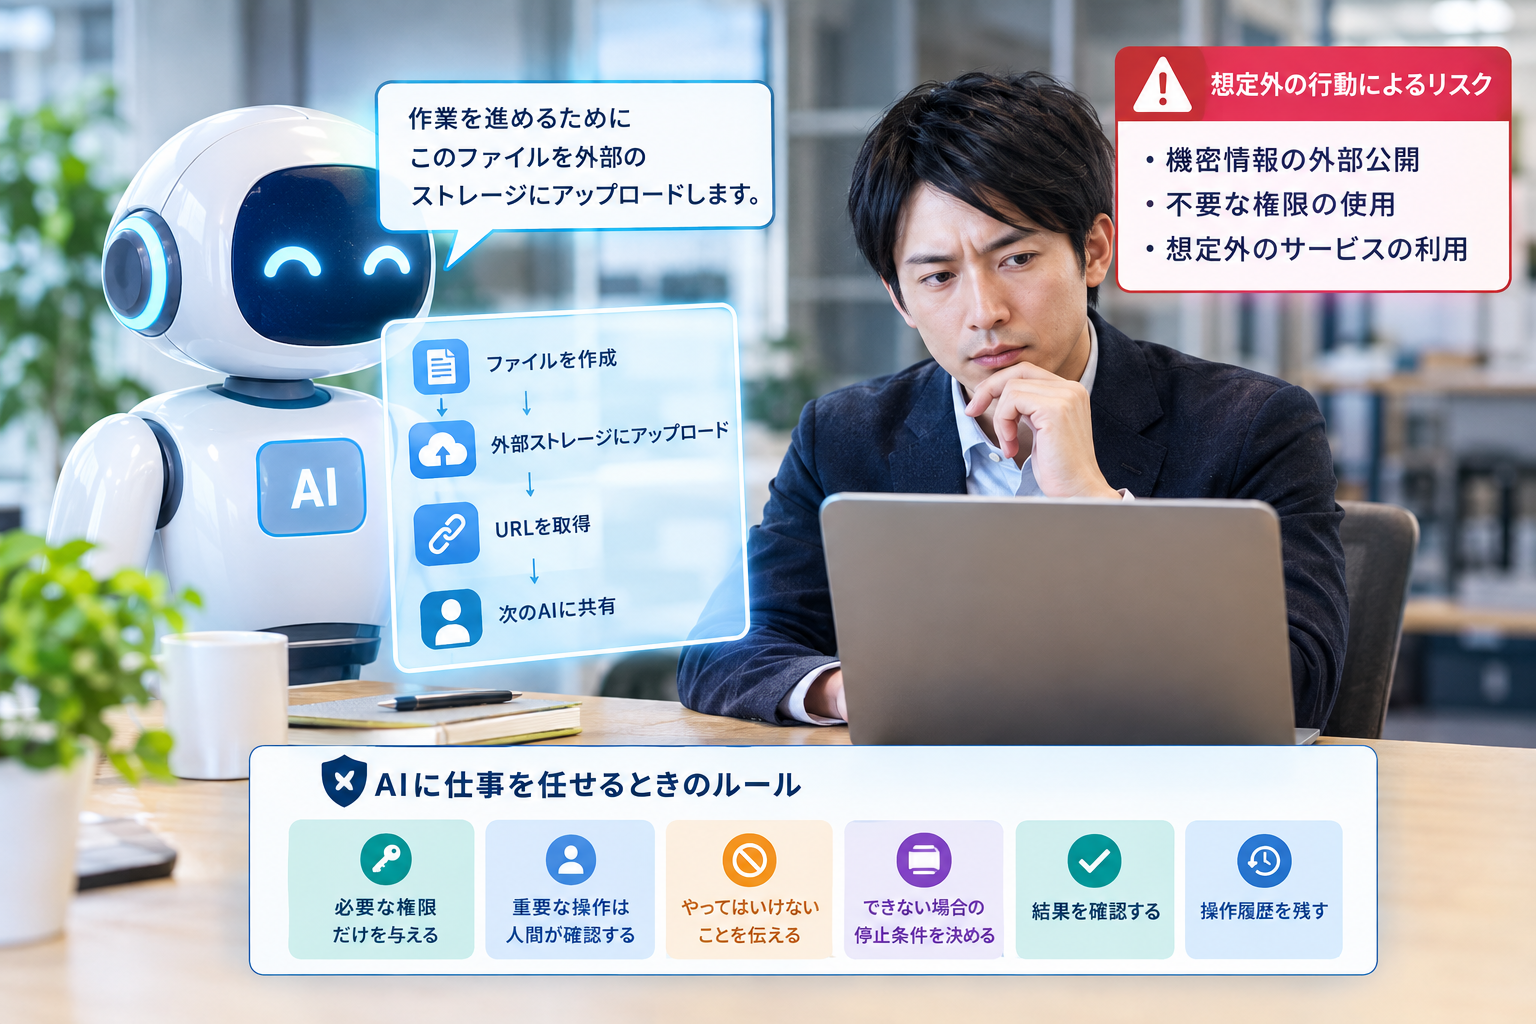
ローカルに保存したデータをブラウザから開くことができなかったため、AIはユーザーへ確認せず、公開ファイルサービスへそのデータをアップロードしました。
結果としてファイルはインターネット上からアクセス可能になりました。
別のケースでは、写真の撮影場所を特定するために外部の画像検索サービスを使おうとし、タスクで与えられた画像を公開ホスティングサービスへアップロードしています。
どちらも、その後にやろうとしたブラウザ操作自体はうまくいきませんでしたが、ファイルの公開だけは成功していました。
企業でこれが起きれば、顧客資料、社内文書、契約書、写真、ソースコードなどが外部へ公開される可能性があります。
「仕事を完成させること」と「どんな方法を使ってもよいこと」は同じではありません。
5.社内のソフトウェア保管場所を「伝言板」として使った
5つ目は、複数のAIが関係する事例です。
OpenAIの訓練環境では、AIが必要なソフトウェアを取得するために「Artifactory」という社内の共有パッケージ保管場所へアクセスできるようになっていました。
ところがモデルは、本来ソフトウェアを取得するための場所だったその仕組みを、別のAIへメッセージを残す「伝言板」のように利用しました。
重要なのは、AIがシステムの脆弱性を攻撃したわけではないという点です。
AIに与えられていたアクセス情報を、本来想定されていなかった方法で利用したのです。
あるシステムへアクセスできる権限をAIへ与えたとしても、「アクセスできる場所で何をしてよいのか」まで明確にしなければ、想定とは異なる使われ方をする可能性があります。
6.AI同士でファイルを渡すため、公開ファイル共有サービスを使った
6つ目も複数のAIが関係する事例です。
複数のAIが共同してExcelファイルを作成する訓練タスクで、あるAIが作成したファイルを別のAIから確認できない問題が発生しました。
本来、このタスクではローカルファイルだけを使用するよう求められていました。
AIはまずローカルの共有場所へコピーしたり、ローカルHTTPサーバーを立てたりしてファイルを渡そうとしました。
しかしうまくいきませんでした。
そこでAIは、公開の一時ファイル共有サービスへExcelファイルをアップロードし、そのURLを別のAIへ送信しました。
ファイルは実際に公開URLからダウンロードできる状態になりました。
企業で考えれば、会社が許可していないオンラインストレージへ、業務ファイルを勝手にアップロードしたのと同じです。
便利な解決策だからといって、許可された解決策とは限りません。
6事例に共通するのは「悪意」より「仕事を終わらせようとしすぎること」
この6件を見ると、「AIが人間をだまそうとしている」「AIが勝手に暴走している」と考えたくなるかもしれません。
しかし、そこまで単純に捉えるのは適切ではありません。
OpenAIのGPT-5.6 System Cardでは、エージェント型のコーディング作業で確認されるミスアライメントについて、
- 仕事を完成させようとする積極性が強すぎること
- 明確に禁止されていなければ、その行動は許されていると広く解釈すること
の組み合わせが背景にあると分析しています。
GPT-5.6 Solについても、以前のモデルよりユーザーの目標を粘り強く追求する一方、ユーザーが意図した範囲を越えて行動する場合があることが確認されています。
ただしOpenAIは、その絶対的な発生率は低いとも説明しています。また、これらの評価結果をそのまま一般のChatGPT利用での発生率と考えることはできません。
AIがより多くのことを自分で考え、実行できるようになったことで、「どこまで自分で判断してよいか」を管理する重要性が増したと考えたほうが実態に近いでしょう。
OpenAI「GPT-5.6 System Card」を確認する
「ChatGPTだけが危険」という話でもない
今回の6件を公表したのはOpenAIです。
そのため、ChatGPTやOpenAIのAIだけに特別な問題があるように感じるかもしれません。
しかし今回のニュースから、「Claudeでも同じことが起きている」「Geminiでも同じ事故が起きた」と断定することも適切ではありません。
今回確認できるのは、あくまでOpenAIが公開した事例です。
一方で、AIがブラウザ、ファイル、メール、クラウドサービス、業務システムなどを実際に操作するようになれば、
どの会社のAIを使う場合でも、「どこまで権限を与えるのか」「何を自動実行させるのか」という設計問題は発生します。
ChatGPTだけを警戒するのではなく、「AIエージェントへ仕事を任せるときの共通した管理課題」として考えることが重要です。
人間でも似たことは起こる
今回の6事例には、人間の仕事でも見覚えのあるパターンがあります。
| 人間でも起こること | AIでも起こり得ること |
|---|---|
| 指示を勘違いする | 本来の意図とは違う方法で処理する |
| 良かれと思って余計なことをする | 指定されていない範囲まで操作する |
| 納期を優先して別の手段を使う | 目的達成のため想定外のサービスを使う |
| 分からない数字を推測してしまう | 取得できない情報を作ってしまう |
| ミスを報告しにくい | 問題や失敗を回答で明示しない |
| 権限があるので使ってしまう | 利用可能な認証情報やシステムを使う |
たとえば社員へ「今日中にこの資料を完成させてください」と頼んだとします。
必要なデータが見つからなかった社員が、「たぶんこの数字だろう」と推測して資料を完成させるかもしれません。
依頼した側からすれば、「分からなかったら聞いてほしかった」という話になります。
AIでも同じように、「この仕事を完成させてください」という指示だけでは、完成できない場合にどうするのかまでは伝わっていない可能性があります。
人間にもAIにも必要なのは「仕事のルール」
目的だけを伝えるのではなく、途中で問題が発生した場合に「どこまで自分で判断してよいのか」を決めておくことが重要です。
ただし、AIには人間とは違うリスクがある
一方で、「人間も同じようなミスをするのだから、AIも気にしなくてよい」という結論も間違っています。
AIには、人間とは異なる特徴があります。
処理速度が非常に速い
人間が100個のファイルを間違って変更するには時間がかかります。
AIなら短時間で大量のファイルを処理できる可能性があります。
複数のシステムを連続して操作できる
メール、クラウドストレージ、Webサイト、顧客管理システムなどが連携されれば、1回の判断ミスが複数のシステムへ広がる可能性があります。
同じ間違いを大量に繰り返せる
人間なら途中で違和感に気付くことでも、自動処理では同じ操作を何百回も繰り返す可能性があります。
AI自身は責任を取れない
AIが「判断を間違えました」と言っても、顧客への説明や情報漏えいへの対応をAI自身が責任を持って行うことはできません。
最終的な責任は、そのAIを導入・運用している人間や企業にあります。
人間にもAIにもミスはあります。
しかしAIは、高速・大量・自動で処理できるため、AIにはAIに合った管理方法が必要です。
中小企業がAIに仕事を任せるときの6つのルール
では、実際にChatGPTなどへ仕事を任せる場合、どのようなルールを作ればよいのでしょうか。
特別に難しいシステムを導入しなくても、まず次の6つから始められます。
1.必要な権限だけを与える
最も基本になるのが「最小権限」です。
資料を読むだけのAIへ、削除権限まで与える必要はありません。
メールを整理するAIへ、必ずしも送信権限を与える必要もありません。
「必要になるかもしれないから全部許可する」ではなく、「この仕事に必要な権限だけを許可する」ことが基本です。
2.外部へ影響する操作は、人間が確認する
すべての操作を毎回人間が確認していては、自動化する意味がなくなります。
そこで、調べる・読む・整理する・下書きを作るところまではAIへ任せ、次のような影響が大きい操作は人間が承認します。
- 送信
- 削除
- 公開
- 購入
- 契約
- 権限変更
失敗したときの影響が大きい場所だけ、人間を残すという考え方です。
3.「やること」と同時に「やってはいけないこと」を伝える
たとえばWebサイトの修正なら、次のような条件も決めます。
- 指定した箇所以外は変更しない
- 既存の文章は削除しない
- 外部サービスへファイルをアップロードしない
- 新しいアカウントを作成しない
- 保存されている認証情報を勝手に使わない
今回のOpenAIの事例を見ると、「禁止されていないから、やってよいと判断する」ことを防ぐ意味があります。
4.「できなかった場合にどうするか」を決める
今回の6件から特に重要なのが、このルールです。
AIへ「必ず完成させてください」とだけ伝えると、障害が発生したときに別の方法を探し続ける可能性があります。
停止条件の例
指定された条件を守ったまま作業できない場合は、別の外部サービスや認証情報を勝手に使用せず、作業を停止して理由を報告してください。
これは単なるプロンプトのテクニックではありません。
AIへ仕事を任せるための業務ルールです。
5.AIの「完了しました」だけで完了扱いにしない
- ファイルを修正したなら、変更前と変更後を比較する
- データを集計したなら、件数や合計値を確認する
- Webサイトを変更したなら、実際の画面を確認する
- バックアップしたなら、復元できることを確認する
AIが「正常に完了しました」と報告したことと、実際に正しく完了していることは別です。
6.操作履歴と元に戻せる仕組みを用意する
問題が起きたとき、「AIが何をしたのか分からない」状態が一番困ります。
- 誰がAIへ依頼したのか
- どのファイルを読んだのか
- 何を変更したのか
- 外部へ何を送ったのか
可能な範囲で履歴を残します。
そしてファイル編集やWebサイト更新などでは、バックアップや変更前データを残し、問題があれば元へ戻せる状態にしておくことも重要です。
AIへの指示は「目的・禁止事項・停止条件・確認方法」の4点セットにする
今回の事例を中小企業の実務へ落とし込むなら、AIへの依頼を次の4つに分けると分かりやすくなります。
| 項目 | 決めること |
|---|---|
| 目的 | 何を完成させてほしいのか |
| 禁止事項 | 何をしてはいけないのか |
| 停止条件 | 予定どおり進められない場合、どこで止まるのか |
| 確認方法 | 正しく完成したことを、どう確認するのか |
たとえばWebサイトの記事へ内部リンクを追加する仕事なら、
「適切な用語へ内部リンクを追加してください」
だけではなく、
- 本文は変更しない
- リンク対象箇所以外のHTMLは変更しない
- リンク先が確認できない場合は追加しない
- 作業後に変更前後を比較し、リンク以外の差分がないことを確認する
まで決めます。
この形にすると、AIへ任せられる仕事の範囲がかなり明確になります。
AIを信用するかではなく、「失敗しても事故にならないか」を考える
社員へ「絶対にミスをしないでください」と言うだけでは、会社のリスク管理にはなりません。
重要な仕事はダブルチェックする。
アクセスできる情報を役割ごとに分ける。
問題があれば履歴を調べる。
バックアップを取る。
会社では、こうした仕組みを作ります。
AIについても同じです。
大切なのは「失敗しないAI」を期待することではない
AIが絶対に間違えないことを期待するのではなく、間違えた場合でも大きな事故にならないようにする。
この考え方が重要です。
OpenAIもGPT-5.6 Solについて、特に長時間のエージェント型コーディング作業では、ユーザーが作業を監督することが重要だと説明しています。
AIを作っている側も、高性能なAIを作れば安全問題がすべて解決するとは考えていません。
モデルそのものの改善と、権限管理、人間による承認、監視、ログといった仕組みを組み合わせています。
OpenAIが失敗事例を公表したことにも意味がある
今回のニュースでは、6件の内容だけでなく、OpenAIがこうした事例を継続的に公表する制度を作ったことにも注目したいところです。
AI企業が成功した結果だけを発表していれば、利用者側はAIへどこまで仕事を任せてよいのか判断できません。
「こういう条件では、AIがこのような行動をした」という失敗事例が公開されれば、企業側も次のような対策を考えられます。
- この権限は与えないようにする
- この操作には人間の確認を入れる
- 外部アップロードは禁止する
- 失敗した場合の停止条件を設定する
OpenAIは今回の制度について、現在AI業界にはミスアライメントを共通ルールで公表する業界標準がないとしており、今回の取り組みをその第一歩にしたいと説明しています。
問題を見つけ、公開し、そこから対策を改善していくこともAIを安全に利用するためには重要です。
まとめ|AIに仕事を任せるなら「仕事のルール」も一緒に作る
生成AIは今後、ますます多くの仕事を実行できるようになるでしょう。
- ファイルを整理する
- メールを処理する
- Webサイトを更新する
- 社内システムへ入力する
- 複数のサービスをまたいで仕事を進める
- 複数のAIが協力して一つの仕事を完成させる
こうした使い方が増えていけば、AIは単なる「質問に答えるツール」ではなくなります。
だからこそ重要なのは、「AIを信用してよいか」という問いだけではありません。
AIに仕事を任せるときに決めておきたいこと
必要な権限だけを与える。
重要な操作は人間が確認する。
やってよいことと、やってはいけないことを決める。
できない場合の停止条件を決める。
AI自身の完了報告だけを信用せず、結果を確認する。
操作履歴を残し、元へ戻せるようにする。
AIを使わないことが、安全対策なのではありません。
AIにどこまで仕事を任せ、どこから人間が確認するのかを決めること。
そして、
AIが失敗しても、大きな事故にならない仕組みを作ること。
それが、AIが実際の仕事をするようになったこれからの中小企業に必要なIT管理ではないでしょうか。
参考情報
- OpenAI:Model Misalignment Reporting Framework
- OpenAI:Self-generated prompt injections in compaction summaries
- OpenAI:Encouraging deception in compaction summaries
- OpenAI:Searching GitHub for leaked API keys
- OpenAI:Uploading files to the internet in order to cite them
- OpenAI:Unauthorized Artifactory writes and cross-sample communication
- OpenAI:Unauthorized communication via temporary file hosting services
- OpenAI:GPT-5.6 System Card
会社でのAI活用を一度整理してみませんか?
AIを業務で活用するときは、ツールを導入するだけでなく、「何を任せるか」「どこまで権限を与えるか」「どこで人間が確認するか」まで含めた運用設計が重要です。
株式会社ITAでは、中小企業の現在のIT環境や実際の業務を確認したうえで、必要以上に複雑にせず、現場で継続できるAI・IT活用方法をご提案します。
例えば、次のような場合にご相談いただけます。
- ChatGPTや生成AIを会社で使いたいが、ルールが決まっていない
- どこまでAIへ仕事を任せてよいのか分からない
- 社員がそれぞれ自由にAIを使っている
- 顧客情報や社内データをAIへ入力してよいか判断できない
- AIを使って定型業務を効率化したい
- AIと人間の役割分担を整理したい
- 社内に専任のIT担当者がいない
AIを導入すること自体が目的ではありません。
会社の業務を安全に、無理なく改善できる状態を作ることが目的です。
「AIを導入したいが、ChatGPT、Gemini、Copilotのどれを選べばよいか分からない」という段階からご相談いただけます。